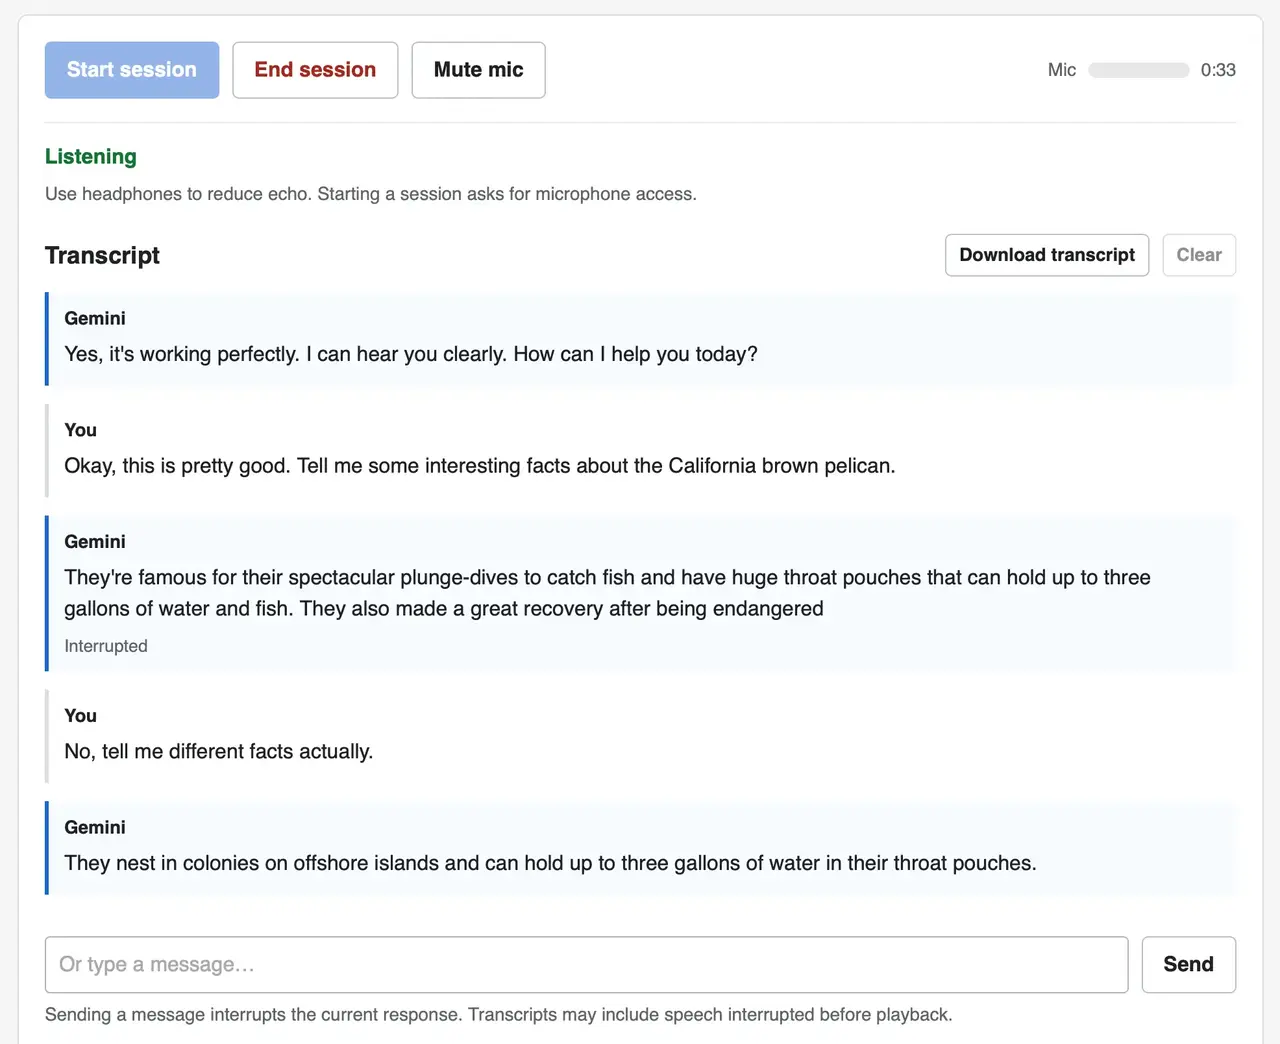
گوگل به تازگی دو مدل جدید گفتار به گفتار (speech-to-speech) به نامهای Gemini 3.8 Live و Gemini 3.8 Live Extended Thinking را منتشر کرده است. این مدلها از نظر ساختار و کارکرد شباهت زیادی به خانواده GPT-Live شرکت OpenAI دارند و امکان مکالمه صوتی مستقیم و بلادرنگ را فراهم میسازند.
جزئیات فنی و نحوه اتصال به مدلهای جدید
بر اساس گزارش سایمون ویلیسون (Simon Willison)، توسعهدهنده نرمافزار، این مدلها قابلیت قطع کردن صحبت هوش مصنوعی (interrupt) در حین گفتگو را دارند. ویلیسون با استفاده از مدل هوش مصنوعی GPT-6 Astra Extra High یک رابط کاربری تحت وب برای آزمایش این مدلهای جدید طراحی کرده است که بدون نیاز به هیچ کتابخانه جانبی کار میکند.
این پیادهسازی مستقیماً به نقطه پایانی WebSocket گوگل به آدرس wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent متصل میشود و برای ضبط و پخش صدا در مرورگر، از Web Audio API و قابلیت AudioContext استفاده میکند. این رویکرد نشان میدهد توسعهدهندگان میتوانند بدون درگیر شدن با کتابخانههای سنگین، ارتباط صوتی دوطرفه با مدلهای جدید Gemini برقرار کنند.