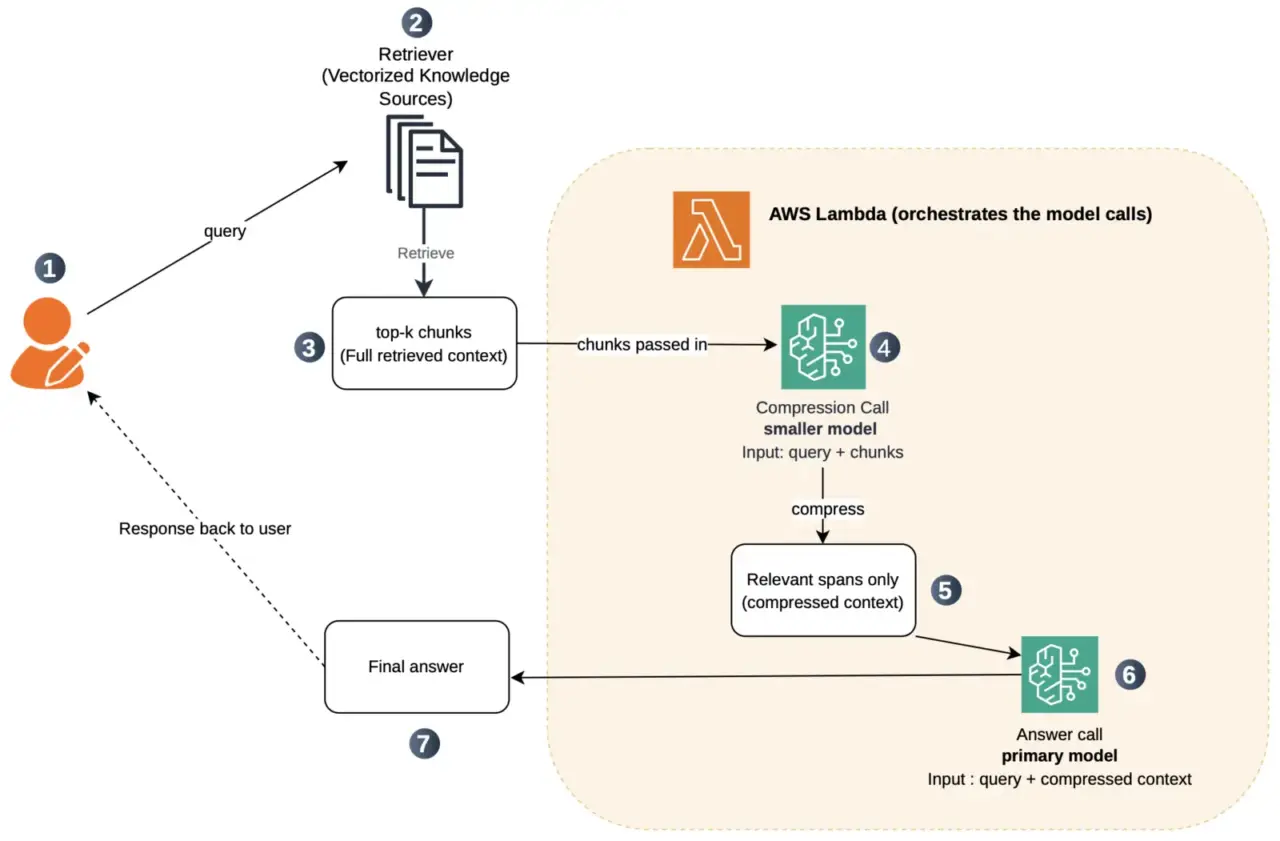
در سیستمهای تولید متن مبتنی بر بازیابی اطلاعات (RAG)، بخش عمدهای از هزینهها به توکنهای ورودی ارسالشده به مدلهای زبانی بزرگ مربوط میشود. برای حل این چالش، پلتفرم Amazon Bedrock الگوی جدیدی به نام «فشردهسازی متن مبتنی بر پرسوجو» (Query-aware context compression) را معرفی کرده است که هزینههای پردازش را به شکل چشمگیری کاهش میدهد.
در معماریهای سنتی RAG، تمام بخشهای بازیابیشده از پایگاه داده (معمولاً بین ۵ تا ۲۰ بخش بزرگ) مستقیماً به مدل اصلی ارسال میشوند. اما در روش جدید، یک مدل کوچکتر و ارزانتر مانند Anthropic Claude Haiku ابتدا متون بازیابیشده را بررسی کرده و تنها بخشهای دقیقاً مرتبط با پرسش کاربر را استخراج میکند. سپس این محتوای فشردهشده به مدل اصلی و قدرتمندتر مانند Anthropic Claude Sonnet فرستاده میشود تا پاسخ نهایی را تولید کند.
این فرآیند دو مرحلهای که از طریق AWS Lambda و Converse API در Amazon Bedrock پیادهسازی میشود، علاوه بر کاهش شدید تعداد توکنهای ورودی و هزینهها، احتمال بروز خطا و توهم (Hallucination) را نیز در مدل اصلی کاهش میدهد؛ زیرا اطلاعات نامرتبط پیش از رسیدن به مدل اصلی حذف میشوند.