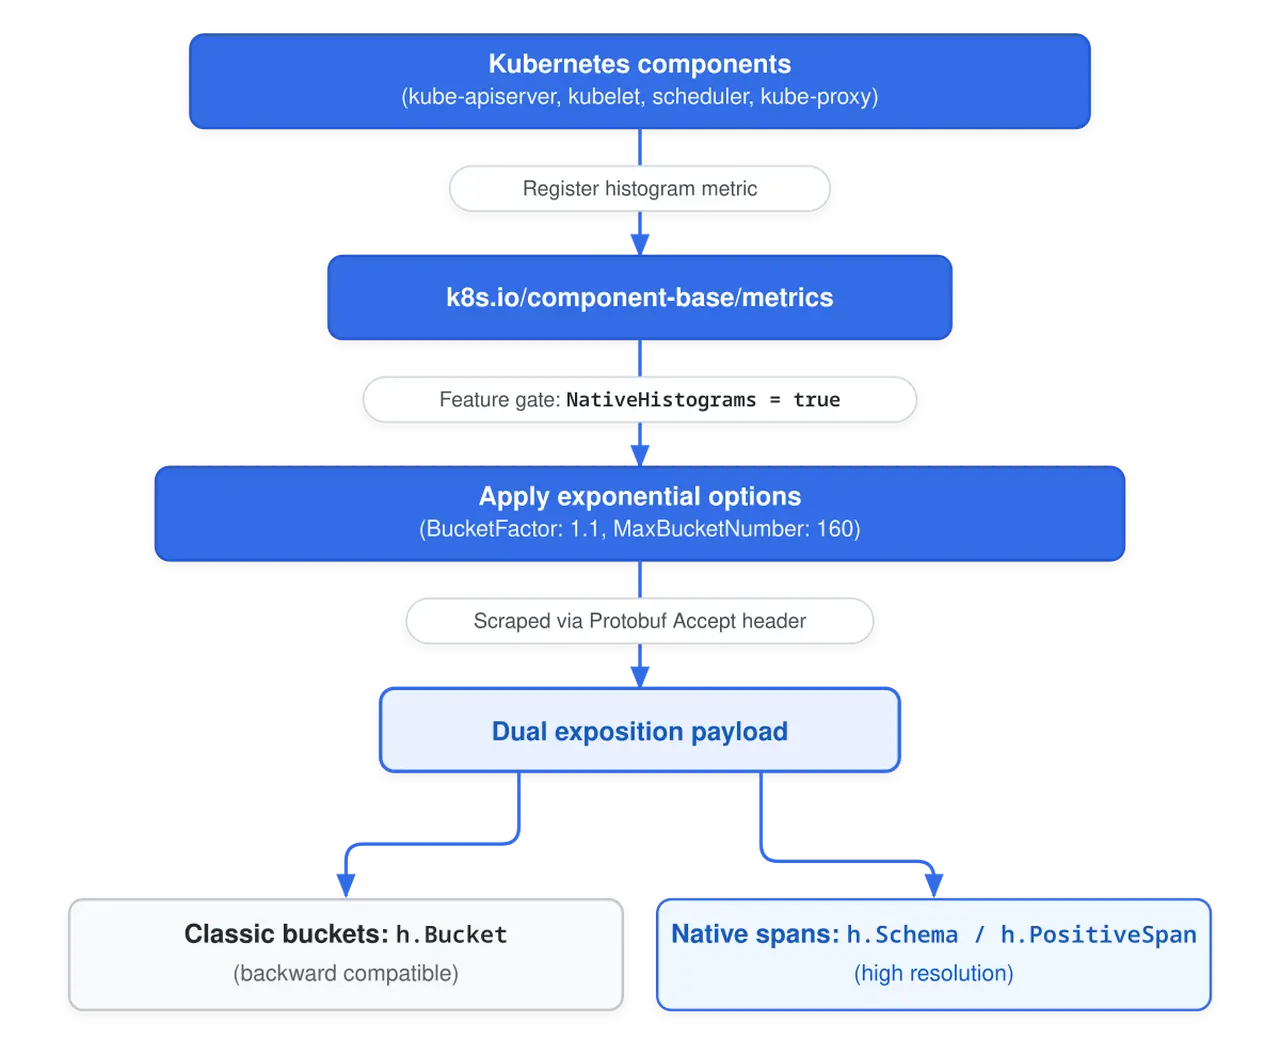
در نسخه جدید Kubernetes (نسخه 1.37)، قابلیت پشتیبانی از هیستوگرامهای بومی (Native Histograms) برای معیارهای سیستم (Metrics) به مرحله Beta ارتقا یافته و به صورت پیشفرض فعال شده است. این قابلیت که پیشتر در نسخه 1.36 به صورت آزمایشی (Alpha) تحت عنوان KEP-5808 معرفی شده بود، امکان نظارت با دقت بالا و هزینه ذخیرهسازی بسیار کمتر را برای اجزای مختلف Kubernetes فراهم میکند.
چرا هیستوگرامهای کلاسیک دیگر کافی نیستند؟
تا پیش از این، معیارهای مربوط به مدتزمان و تاخیر (مانند تاخیر درخواستهای API Server) به هیستوگرامهای کلاسیک Prometheus متکی بودند. این روش قدیمی سه چالش عمده داشت: نخست، نیاز به حدس زدن و تعریف دستی محدودههای ثابت (Buckets) پیش از مشاهده توزیع واقعی دادهها؛ دوم، افزایش شدید تعداد سریهای زمانی (High Cardinality) و در نتیجه بالا رفتن هزینه ذخیرهسازی در دیتابیسهای سری زمانی (TSDB)؛ و سوم، خطای محاسباتی بالا در تخمین صدکها (Quantiles) به دلیل استفاده از درونیابی خطی بین محدودههای زمخت.
قابلیت Native Histograms در Prometheus با جایگزین کردن محدودههای ثابت با محدودههای پویا و نمایی (Exponential Buckets)، این مشکلات را برطرف میکند. این رویکرد جدید علاوه بر تنظیم خودکار محدوده دقت از نانوثانیه تا ساعت، تعداد سریهای زمانی را تا ۹۰ درصد کاهش داده و محاسبات صدک را با خطای ریاضی بسیار کم (حداکثر ۵ درصد در تنظیمات پیشفرض) انجام میدهد.
نحوه عملکرد و سازگاری در Kubernetes
این قابلیت مستقیماً درون زیرسیستم معیارهای مشترک Kubernetes (کتابخانه k8s.io/component-base/metrics) پیادهسازی شده است. برای جلوگیری از بروز هرگونه اختلال در ابزارهای مانیتورینگ فعلی، از مکانیزم «نمایش دوگانه» (Dual Exposition) استفاده میشود. در این حالت، معیارهای کلاسیک همچنان در کنار ساختارهای بومی جدید ارسال میشوند تا داشبوردها و هشدارهای قدیمی بدون تغییر به کار خود ادامه دهند، در حالی که جمعآوریکنندههای مدرنتر میتوانند دادههای بومی را در قالب Protobuf دریافت کنند.
تمام اجزای اصلی کنترلپلین و نودها از جمله kube-apiserver، kube-scheduler، kubelet، kube-controller-manager و kube-proxy به طور خودکار از این قابلیت پشتیبانی میکنند.
نحوه پیکربندی در Prometheus
با توجه به فعال بودن پیشفرض این ویژگی در Kubernetes v1.37، نحوه جمعآوری (Scrape) این معیارها به نسخه Prometheus شما بستگی دارد:
در Prometheus 3.0 و نسخههای جدیدتر، توصیه میشود تنظیمات به صورت مجزا برای هر جاب (Scrape Job) اعمال شود. در طول دوره انتقال، حتماً باید گزینه always_scrape_classic_histograms: true فعال باشد تا داشبوردها و هشدارهای قدیمی مبتنی بر معیارهای کلاسیک از کار نیفتند.
در Prometheus نسخه 2.40 تا 2.x، این ویژگی باید با فعالسازی فلگ سراسری --enable-feature=native-histograms در زمان اجرای Prometheus فعال شود.