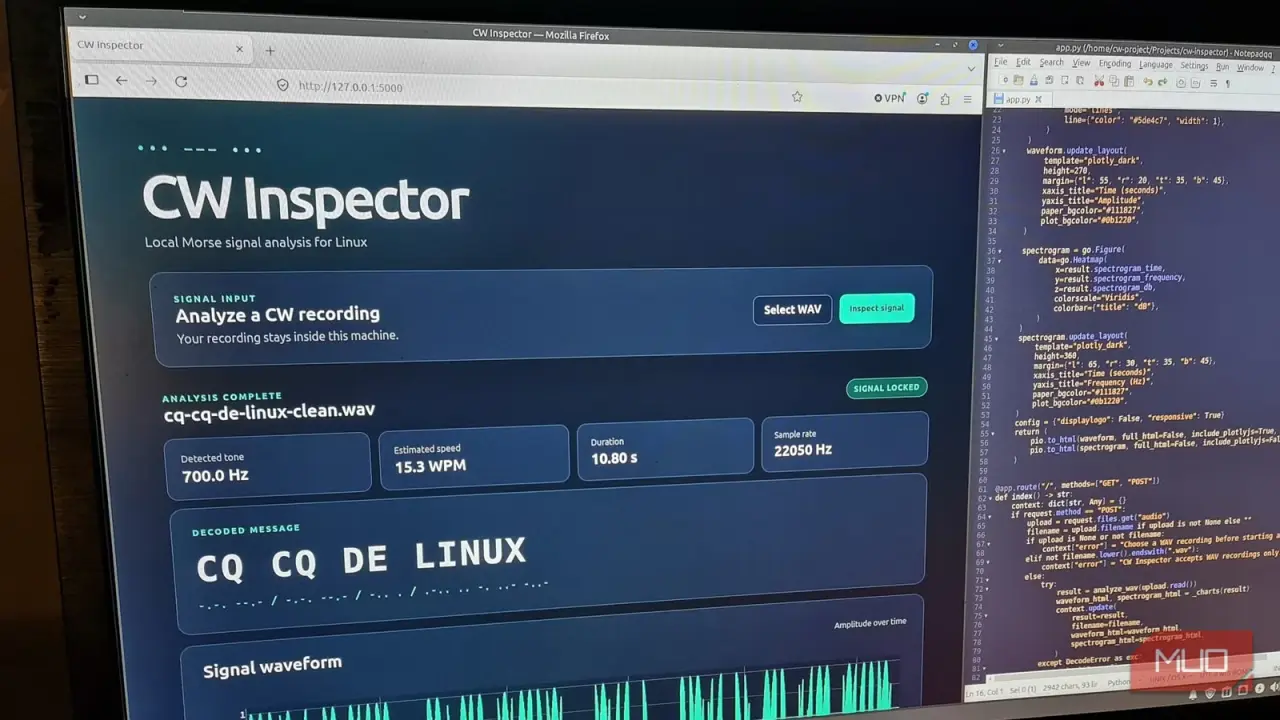
توسعه روزافزون ابزارهای هوش مصنوعی مولد، پدیدهای به نام «برنامهنویسی حسی» (Vibe Coding) را رایج کرده است؛ روشی که در آن کاربران صرفاً از طریق گفتگو با هوش مصنوعی برنامههای خود را میسازند. با این حال، نگهداری و تایید صحت این کدها چالش بزرگی است. هسته لینوکس (Linux kernel) برای حل این مشکل، دستورالعملهایی را برای مستندسازی و شفافسازی کدهای تولیدشده توسط ابزارهای خودکار ارائه داده است که به توسعهدهندگان کمک میکند خطاهای پنهان این ابزارها را شناسایی و مدیریت کنند.
مستندسازی ابزارها و فرضیات اولیه
بر اساس این دستورالعملها، اولین گام ثبت دقیق ابزار اصلی تولیدکننده کد است. توسعهدهنده باید مشخص کند کدام بخشهای کلیدی پروژه (مانند توابع، فایلهای منبع یا ترجمهها) توسط هوش مصنوعی تولید شدهاند. در یک نمونه آزمایشی، توسعهدهندهای برای ساخت برنامه رمزگشای کد مورس به نام CW Inspector از ابزار OpenAI Codex استفاده کرد و با ثبت دقیق نقش این ابزار در کنار کتابخانههای Flask، NumPy و SciPy، فرآیند ارزیابی کد را آغاز نمود.
گام دوم، حفظ و ذخیره ورودیها، پرامپتها و نیازمندیهای اولیه پشت هر خروجی است. ثبت این موارد در قالب فایلهایی مانند PRODECT_SPEC.md به توسعهدهنده اجازه میدهد تا بدون اتکا به حدس و گمان، تستهای مستقلی را برای سنجش عملکرد برنامه طراحی کند.
ثبت مسیر پرامپتها و تعیین مرز کدهای تولیدی
گام سوم بر حفظ مسیر پرامپتها (Prompt Trail) تاکید دارد. در پروژههای طولانی، نوشتن خلاصهای از دستورالعملهای دادهشده به هوش مصنوعی (مانند فایل AI_ASSISTANCE.md) به شفافسازی هدف اصلی کد کمک میکند. این کار فرآیند عیبیابی را هنگام بروز رفتارهای غیرمنتظره تسهیل میسازد؛ چرا که برنامهنویس میتواند رفتار فعلی کد را با نیت اولیه خود مقایسه کند.
در نهایت، گام چهارم مشخص کردن دقیق بخشهایی است که هوش مصنوعی در آنها دخالت داشته است. برنامهنویس باید مرز میان کدهای نوشتهشده توسط خود و کدهای تولیدی هوش مصنوعی را با ذکر نام فایلها (مانند قالبهای HTML، استایلشیتها یا فایلهای تنظیمات) کاملاً شفاف کند تا بازبینی و ارزیابی امنیتی آنها با دقت بیشتری انجام شود. این قوانین نشان میدهند که هوش مصنوعی ابزار مفیدی است، به شرط آنکه فرآیند توسعه آن شفاف و قابل تایید باشد.